Файл robots.txt: как составить и проверить
Robots.txt - текстовый файл в корне сайта, в котором вы говорите поисковым роботам, какие разделы обходить не нужно и где лежит карта сайта. Он нужен почти каждому сайту, а ошибка в одной строке может закрыть от поиска весь сайт. Ниже синтаксис, готовые примеры и способы проверить файл.
Содержание
Что такое robots.txt и где он лежит
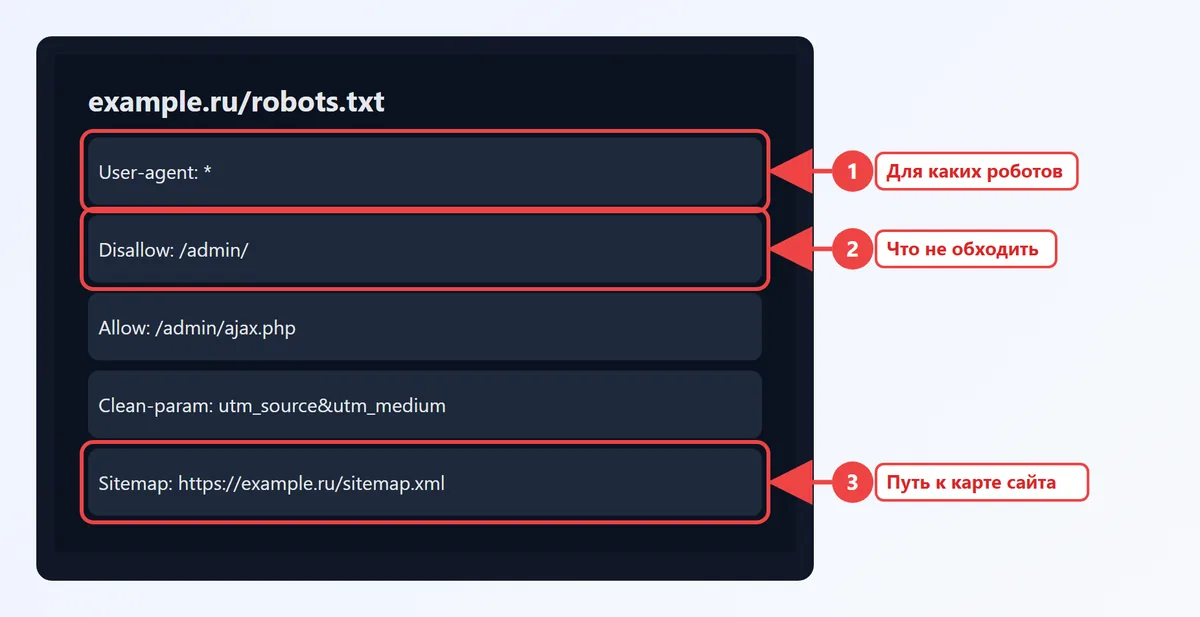
Файл robots txt всегда находится по одному адресу: https://example.ru/robots.txt. Робот Яндекса, Google и других систем запрашивает его первым, ещё до обхода страниц. Если файла нет, роботы считают, что можно обходить всё. Как посмотреть robots.txt любого сайта: просто допишите /robots.txt к адресу главной.
Важно понимать границы: robots.txt управляет обходом, а не индексацией. Запрещённая страница может оказаться в поиске без описания, если на неё ведут ссылки. Чтобы надёжно убрать страницу из выдачи, нужен мета-тег noindex и открытый для робота адрес, иначе он этот тег не увидит. О проверке результата читайте в статье как проверить индексацию сайта.
Синтаксис и основные директивы
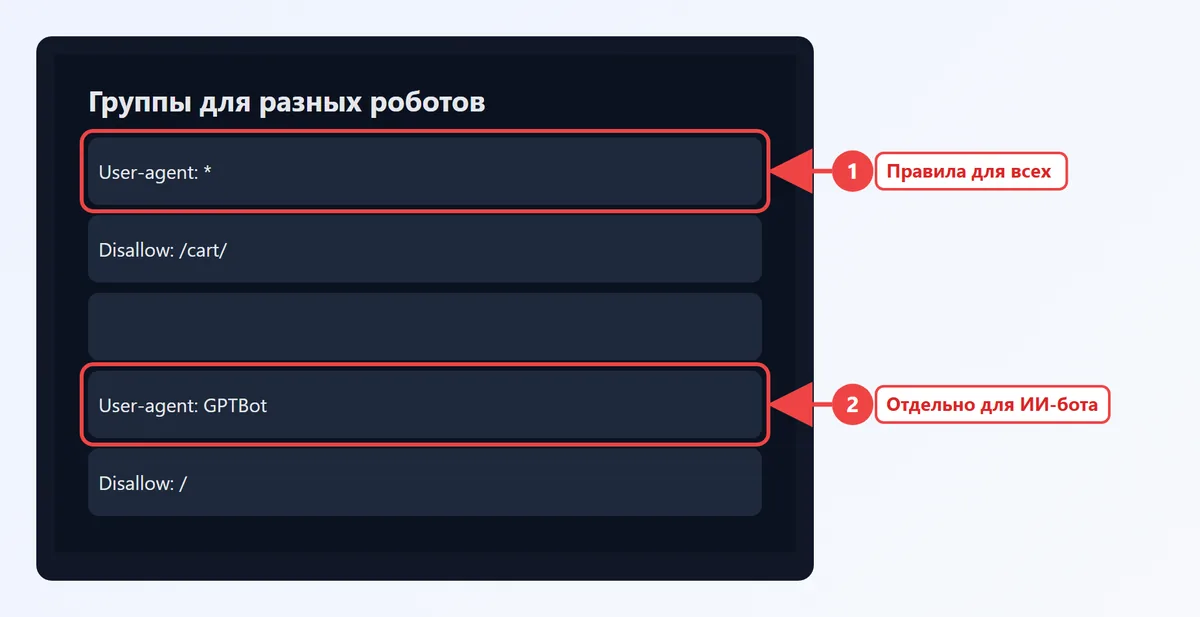
Файл состоит из групп. Каждая группа начинается со строки User-agent и содержит правила для указанного робота. Пустая строка отделяет группы, строки с # считаются комментариями.
| Директива | Что делает | Пример |
|---|---|---|
| User-agent | Для какого робота группа правил, * значит для всех | User-agent: Yandex |
| Disallow | Запрещает обход адресов, начинающихся с указанного пути | Disallow: /admin/ |
| Allow | Разрешает обход внутри запрещённого раздела | Allow: /admin/ajax.php |
| Sitemap | Полный адрес карты сайта | Sitemap: https://example.ru/sitemap.xml |
| Clean-param | Только Яндекс: какие GET-параметры не меняют содержимое | Clean-param: utm_source&utm_medium |
Disallow: что значит и как работает
Disallow сравнивает начало адреса. Правило Disallow: /search закроет и /search, и /search/?q=1, и /searchpage.html. Пустое значение Disallow: ничего не запрещает. Чтобы запретить индексацию сайта через robots.txt целиком, пишут Disallow: /, это работает для обхода, но на рабочем сайте такая строка означает почти полное выпадение из поиска.
Спецсимволы * и $
Звёздочка * заменяет любую последовательность символов, знак $ фиксирует конец адреса.
Disallow: /*?sort=- закрыть все адреса с параметром сортировки;Disallow: /*.pdf$- закрыть PDF-файлы;Disallow: /tag/$- закрыть только страницу/tag/, но не/tag/seo/.
Приоритет Allow и Disallow
Если адрес подходит под оба правила, побеждает более длинное (более точное). При равной длине Яндекс и Google выбирают Allow. Порядок строк внутри группы значения не имеет.
Clean-param в robots.txt
Clean-param понимает только Яндекс. Директива говорит, что параметры вроде меток UTM или идентификаторов сессий не меняют страницу, и робот склеивает такие адреса в один. Формат: список параметров через &, затем через пробел необязательный путь.
Clean-param: utm_source&utm_medium&utm_campaign&utm_content&utm_term
Clean-param: yclid&ysclid&gclid
Clean-param: sid /catalog/
Если вы размечаете рекламу метками в генераторе UTM-меток, такая строка избавит от дублей с метками в Вебмастере. Для Google дубли с параметрами решаются тегом canonical, об этом статья тег rel=canonical.
Устаревшие директивы
Host Яндекс больше не учитывает: главное зеркало задаётся 301 редиректом. Crawl-delay Яндекс тоже игнорирует, скорость обхода настраивается в Вебмастере, а Google эту директиву не поддерживал никогда. Оставлять их в файле не опасно, но и пользы нет.
Готовые примеры robots.txt
Ниже шаблоны, от которых удобно отталкиваться. Замените домен и проверьте пути под свою структуру. Быстро собрать файл с нужными правилами можно в генераторе robots.txt.
Robots.txt для WordPress
WordPress по умолчанию отдаёт виртуальный файл, если в корне нет настоящего. Стандартный robots.txt для WordPress обычно выглядит так:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-login.php
Disallow: /?s=
Disallow: /search/
Disallow: /*?replytocom=
Disallow: /feed/
Disallow: /*/feed/

Clean-param: utm_source&utm_medium&utm_campaign&utm_content&utm_term

Sitemap: https://example.ru/sitemap.xml
Не закрывайте /wp-content/ и /wp-includes/: там лежат стили и скрипты, без которых робот видит страницу сломанной и хуже оценивает её на мобильных.
Robots.txt для интернет-магазина
В магазине главная задача - убрать из обхода корзину, личный кабинет и бесконечные комбинации фильтров и сортировок.
User-agent: *
Disallow: /cart/
Disallow: /checkout/
Disallow: /account/
Disallow: /compare/
Disallow: /*?sort=
Disallow: /*&sort=
Disallow: /*?limit=

Clean-param: utm_source&utm_medium&utm_campaign
Clean-param: sort&limit /catalog/

Sitemap: https://example.ru/sitemap.xml
Фильтры, которые собирают спрос (например "кроссовки мужские черные"), лучше не закрывать, а превратить в отдельные посадочные страницы с нормальными адресами.
Robots.txt на Тильде и конструкторах
Тильда и большинство конструкторов создают файл автоматически. Вписать в него свои строки обычно нельзя, но закрыть конкретную страницу от индексации можно в её настройках (во вкладке SEO). Если нужен полный контроль над файлом, это повод перейти на CMS.
Как запретить или открыть доступ ИИ-ботам
Роботы, собирающие тексты для нейросетей, тоже читают robots.txt. У каждого своё имя, например GPTBot, ClaudeBot, Google-Extended. Чтобы закрыть сайт для одного из них, добавьте отдельную группу:
User-agent: GPTBot
Disallow: /
Чтобы открыть доступ ИИ-боту, достаточно не запрещать его или написать для него пустой Disallow:. На обычный поиск Яндекса и Google эти группы не влияют.
Как проверить robots.txt
Проверка robots txt занимает пару минут и спасает от неприятных сюрпризов после обновления сайта.
- Откройте
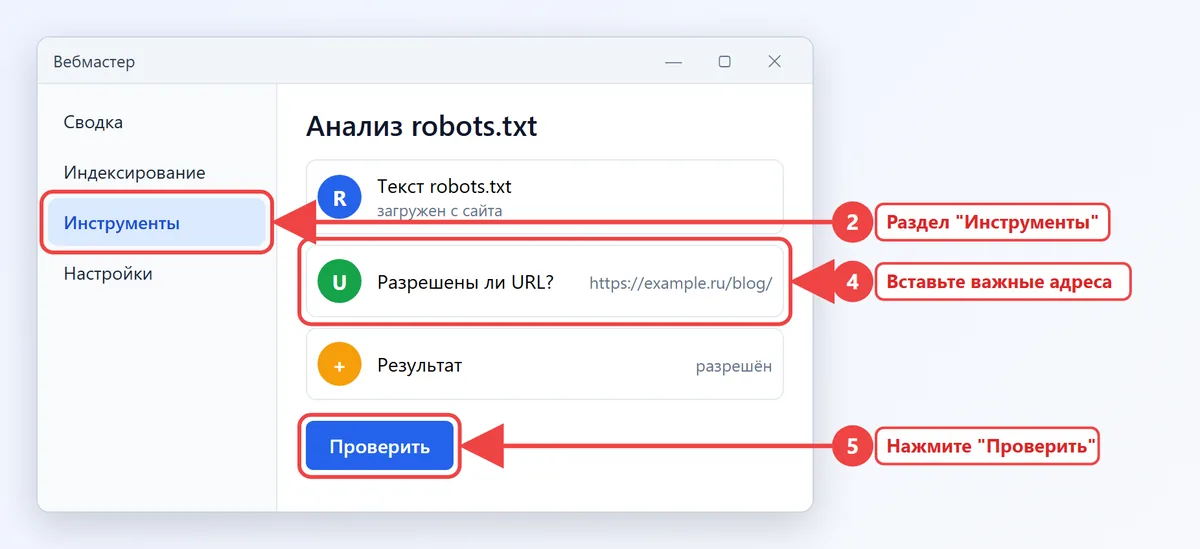
https://example.ru/robots.txtв браузере. Файл должен открываться с кодом 200 и как простой текст. - В Яндекс Вебмастере перейдите в "Инструменты - Анализ robots.txt".
- Посмотрите, нет ли ошибок в разборе файла: сервис подсветит строки, которые не понял.
- В поле "Разрешены ли URL?" вставьте несколько важных адресов: главную, категорию, статью, товар.
- Нажмите "Проверить" и убедитесь, что нужные страницы разрешены, а служебные закрыты.
В Google Search Console есть отчёт о файле robots.txt (в настройках ресурса): он показывает, какую версию файла видит Google и были ли ошибки загрузки. Если сайт ещё не подключён к Вебмастеру, начните с инструкции как добавить сайт в Яндекс Вебмастер.
Файл robots.txt должен быть доступен на чтение всем (права доступа обычно 644). Если сервер отдаёт на него ошибку 5xx, Google может временно перестать обходить сайт.
Частые ошибки в robots.txt
Disallow: /после разработки. Тестовая версия была закрыта, а при запуске файл забыли поменять. Самая дорогая ошибка: сайт выпадает из поиска целиком.- Закрыты CSS, JS и картинки. Робот не может отрисовать страницу и хуже понимает её содержимое.
- Неправильное имя или место файла. Правильно
robots.txtмаленькими буквами, только в корне домена. Поддомены требуют своего файла. - Кириллица в путях без кодирования. Адреса с русскими буквами указывайте в закодированном виде, как их видит браузер в коде.
- Попытка спрятать секретный раздел. Robots.txt открыт всем, и строка
Disallow: /private-admin/подсказывает, где искать. Закрывайте такое паролем. - Пробелы и лишние символы. Каждая директива пишется с новой строки, после двоеточия значение, без кавычек.
Если вы переносите сайт на новый домен или https, robots.txt нужно проверить и на старом, и на новом адресе, а склейку делать 301 редиректом. Остальные технические проверки собраны в чек-листе SEO-аудита сайта.
Частые вопросы
Обязателен ли robots.txt?
Нет, без него сайт будет индексироваться. Но файл помогает убрать из обхода служебные страницы и дубли и сообщить адрес sitemap, поэтому его стоит сделать.
Как закрыть от индексации одну страницу?
<meta name="robots" content="noindex"> на самой странице. Строка Disallow в robots.txt запрещает обход, но не всегда убирает адрес из выдачи.Через сколько поисковики учтут изменения robots.txt?
Роботы перечитывают файл часто, обычно в течение суток. Изменения в выдаче появятся позже, по мере повторного обхода страниц.
Как создать robots.txt онлайн?
Нужно ли прописывать Sitemap и для Яндекса, и для Google?
Одной строки Sitemap в конце файла достаточно: её читают все роботы независимо от групп. Можно указать несколько карт, каждую отдельной строкой.
Что значит Disallow без значения?
Пустой Disallow ничего не запрещает: робот может обходить весь сайт. Так пишут, когда нужна группа для робота без ограничений.